文本与排版
为什么 Word 与在线字数统计工具的结果不同:连字符、标点与算法解析
即刻统计字数与字符数: 在浏览器本地实时分析单字、字符、句子、段落及预估阅读耗时,全程零数据上传。
打开字数统计器
目录
1. 核心诊断:为什么不同工具统计的字数不一致
将同一篇文档粘贴到 Microsoft Word、Google 文档以及在线字数统计工具中,通常会得出不同的结果。这并非程序错误,而是由于各个底层文本引擎的分词算法(Tokenization)与字符边界规则存在本质区别。
绝大多数差异来源于以下五个关键技术维度:
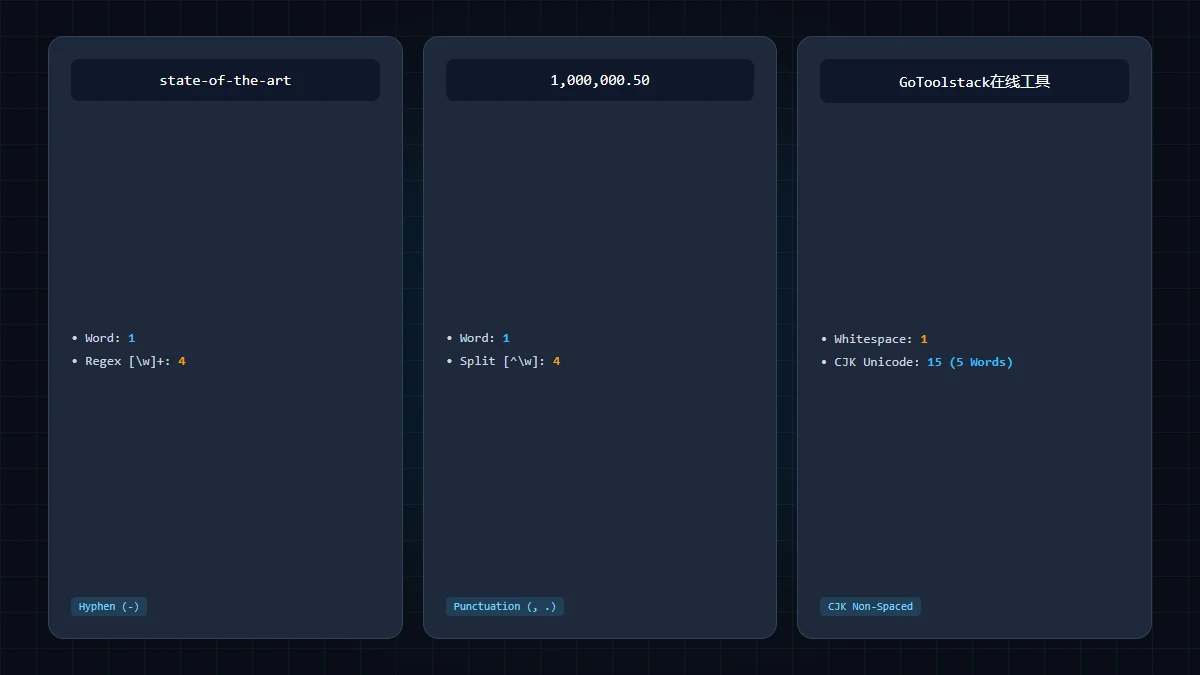
- 连字符复合词: 诸如
state-of-the-art或web-based应当算作一个单词还是多个单词? - 撇号与缩写:
don't、user's会被视作独立单词还是切分为两部分? - 短横线与破折号: 普通连字符(
-)与长破折号(—/–)在分词上的不同逻辑。 - Emoji 与 UTF-16 编码长度: 单个表情符号究竟算 1 个字符还是 2 个 UTF-16 代码单元?
- 中日文等无空格语言(CJK): 缺少空格分界时,西文分词器如何判定边界?
2. 四大核心指标:字数、含空格字符、不含空格字符与段落数
在评估统计数据前,必须严格区分以下四类指标:
| 统计维度 | 度量范畴 | 技术定义与规则 |
|---|---|---|
| 单词数 (Words) | 词法单元 | 由空格或标点符号分隔的连续 Unicode 字母与数字序列。 |
| 字符数 (含空格) | 文本总缓冲区大小 | 包含空格、制表符、换行符及标点在内的所有代码单元总数。 |
| 字符数 (不含空格) | 可见文本密度 | 剔除所有 ASCII 和 Unicode 空白字符后的净字符长度。 |
| 段落数 | 结构化内容块 | 由连续换行符 (\n+) 隔开的非空文本块总数。 |
3. GoToolstack 字数统计引擎真实源码机制
在 GoToolstack 纯前端字数统计工具中,采用现代 Unicode 正则表达式进行解析:
const rawWords = v.match(/[\p{L}\p{N}]+(?:['’\-][\p{L}\p{N}]+)*/gu) || [];
const words = rawWords.length;
const chars = v.length;
const charsns = v.replace(/\s/g, '').length;
const sentences = (v.match(/[.!?]+(\s|$)/g) || []).length;
const paras = v.trim() === '' ? 0 : v.split(/\n+/).filter(p => p.trim().length > 0).length;
该引擎在实际运行中的具体表现:
- 连字符词组: 表达式包含
(?:['’\-][\p{L}\p{N}]+)*,因此state-of-the-art与e-commerce均被精准计为 1 个单词。 - 撇号保留: 包含直撇号(
')或弯撇号(’)的单词(如don't、O'Connor)保持为 1 个单词。 - 长破折号(Em-dash): 破折号(
—)不在正则字符组内,因此data—driven会被拆分为 2 个独立单词。 - Emoji 与 UTF-16 长度: JavaScript 的
v.length统计 UTF-16 代码单元。单个火箭 🚀 (U+1F680) 包含代理对,占 2 个字符;而家庭 Emoji (👨👩👧👦) 占用 11 个代码单元。
4. Microsoft Word 与在线统计工具对比:微软官方规则
在 Microsoft Word 中(根据 Microsoft Word 官方规范说明):
- Word 默认将连字符连接的复合词计为 1 个单词。
- 是否计入页脚、尾注和文本框,取决于“字数统计”对话框中是否勾选了包含文本框、脚注和尾注。
- 斜杠连接的词语(如
read/write)会根据校对语言字典的不同被判定为 1 个或 2 个单词。
5. 阅读与演讲耗时预估:速度常数与经验模型
工具展示的阅读与演讲时间并非绝对物理时间,而是基于人类语言学经验模型的估算:
- 默读耗时: GoToolstack 设定成年人平均默读速度为 200 词/分钟 (WPM) (
Math.round(words / 200))。学术文献(Brysbaert, 2019)指出非虚构类阅读均值约为 238 WPM,专业科技文献通常降至 150–180 WPM。 - 口语演讲耗时: 设定语速为 130 词/分钟 (
Math.round(words / 130)),符合专业演讲与主持推荐标准。
6. 无空格语言:中日文 (CJK) 场景下的局限性说明
中文与日文采用连续书写,词语之间不使用空格隔开(例如:我喜欢编写软件 或 日本語の文字数を数える)。
由于西文分词正则会将连续的 Unicode 字母连续匹配([\p{L}\p{N}]+),整句没有空格的中文会被判定为 1 个单词!因此,对于中文和日文排版,用户应当以 不含空格字符数 (charsns) 作为真实字数的唯一衡量标准。
7. GoToolstack 文本处理工具库
无需向任何服务器上传文本,在本地浏览器中安全处理字符:
技术规范与官方标准参考
- Microsoft Support: 在 Microsoft Word 中统计字数与字符数官方指南(桌面端、网页版、Mac 与包含脚注选项)。
- Brysbaert, M. (2019): 我们每分钟能读多少字?阅读速率的系统综述与元分析(Journal of Memory and Language,2019)。
- Unicode Standard Annex #29: Unicode 标准附件第29号:文本分词处理(单词边界、字形簇与句子划分规范)。