Kelime Sayısı Neden Farklı Çıkıyor? Word, Karakter Sayımı ve Okuma Süresi
İçindekiler
- Doğrudan Teşhis: Kelime Sayımı Neden Farklı Sonuç Verir?
- Dört Temel Metrik: Kelime, Boşluklu/Boşluksuz Karakter ve Paragraf
- GoToolstack Kelime Sayacı Motoru: Gerçek Kaynak Kod Mekaniği
- Microsoft Word vs. Çevrim İçi Sayaçlar: Resmî Word Kuralları
- Okuma ve Konuşma Süresi: Hız Varsayımları ve Tahminler
- Boşluksuz Diller: Çince ve Japonca (CJK) Sınırları
- GoToolstack Metin Araçları
- Teknik Referanslar ve Resmi Standartlar
1. Doğrudan Teşhis: Kelime Sayımı Neden Farklı Sonuç Verir?
Aynı metni Microsoft Word'e, Google Dokümanlar'a ve çevrim içi bir kelime sayacına yapıştırdığınızda genellikle üç farklı kelime ve karakter sonucu elde edersiniz. Bu durum bilgisayarınızdaki bir arızadan veya metnin bozulmasından kaynaklanmaz; yazılımların kullandığı kelime ayırma (tokenization) algoritmaları ve karakter sınır kurallarının farklı olmasının doğal bir sonucudur.
Farklılıkların %95'i şu beş teknik ayrımdan doğar:
- Tireli birleşik kelimeler:
yüz yüze,web-tabanlıveyastate-of-the-arttek kelime mi yoksa birden fazla kelime mi sayılmalıdır? - Kesme işaretleri ve ekler:
Ali'ninveyadon'tifadesi tek kelime mi, iki kelime mi? - Çizgiler ve ayırıcılar: Kısa çizgi (
-) ile uzun düşünce çizgisi (—) arasındaki fark. - Emojiler ve UTF-16 bayt boyutu: Tek bir emoji 1 karakter mi yoksa bellekte 2 UTF-16 birimi mi tutar?
- Boşluksuz diller (CJK): Çince ve Japonca gibi kelimeler arasında boşluk kullanılmayan dillerde kelime sınırı nasıl bulunur?
2. Dört Temel Metrik: Kelime, Boşluklu/Boşluksuz Karakter ve Paragraf
Araçları karşılaştırmadan önce şu dört temel metriğin tanımını kesinleştirmelisiniz:
| Metrik | Neyi Ölçer? | Teknik Tanım |
|---|---|---|
| Kelime | Anlamsal sözcük birimi | Boşluk veya ayırıcılarla sınırlandırılmış Unicode harf ve rakam dizileri. |
| Karakter (boşluklu) | Toplam metin boyutu | Boşluklar, sekmeler, satır sonları ve noktalama dahil tüm karakterler. |
| Karakter (boşluksuz) | Görünür metin yoğunluğu | Tüm boşluk ve satır sonu karakterleri temizlendikten sonraki uzunluk. |
| Paragraf | Yapısal metin blokları | Satır sonu karakterleriyle (\n+) ayrılan dolu metin blokları. |
3. GoToolstack Kelime Sayacı Motoru: Gerçek Kaynak Kod Mekaniği
GoToolstack'in istemci taraflı Kelime Sayacı aracında sayım işlemi şu doğrulanmış JavaScript düzenli ifadesiyle yapılır:
const rawWords = v.match(/[\p{L}\p{N}]+(?:['’\-][\p{L}\p{N}]+)*/gu) || [];
const words = rawWords.length;
const chars = v.length;
const charsns = v.replace(/\s/g, '').length;
const sentences = (v.match(/[.!?]+(\s|$)/g) || []).length;
const paras = v.trim() === '' ? 0 : v.split(/\n+/).filter(p => p.trim().length > 0).length;
Bu motorun gerçek çalışma sonuçları şunlardır:
- Tireli kelimeler: İfade
(?:['’\-][\p{L}\p{N}]+)*kuralını içerdiğindenstate-of-the-art,ar-geveyayol-boyutek kelime (1 kelime) sayılır. - Kesme işaretleri: Hem düz (
') hem eğik tipografik kesme (’) işareti içerenAli'ninveyaAhmet’inifadeleri tek bir bütün olarak 1 kelime sayılır. - Uzun çizgiler (Em-dash): Uzun çizgi (
—) regex deseninde bulunmadığındankarar—destekifadesi 2 ayrı kelime olarak ayrıştırılır. - Emojiler: JavaScript'te
v.lengthUTF-16 kod birimlerini (code units) sayar; bu durum görsel kullanıcı karakteri (grafem kümesi) ve bayt boyutundan farklıdır. Standart bir 🚀 emojisi bir vekil çiftinden (surrogate pair) oluştuğu içinv.length2 karakter üretir. Aile emojileri (👨👩👧👦) ise sıfır genişlikli bağlayıcılarla 11 birim tutar.
4. Microsoft Word vs. Çevrim İçi Sayaçlar: Resmî Word Kuralları
Microsoft Word uygulamasında (Microsoft Word resmî dokümantasyonuna göre):
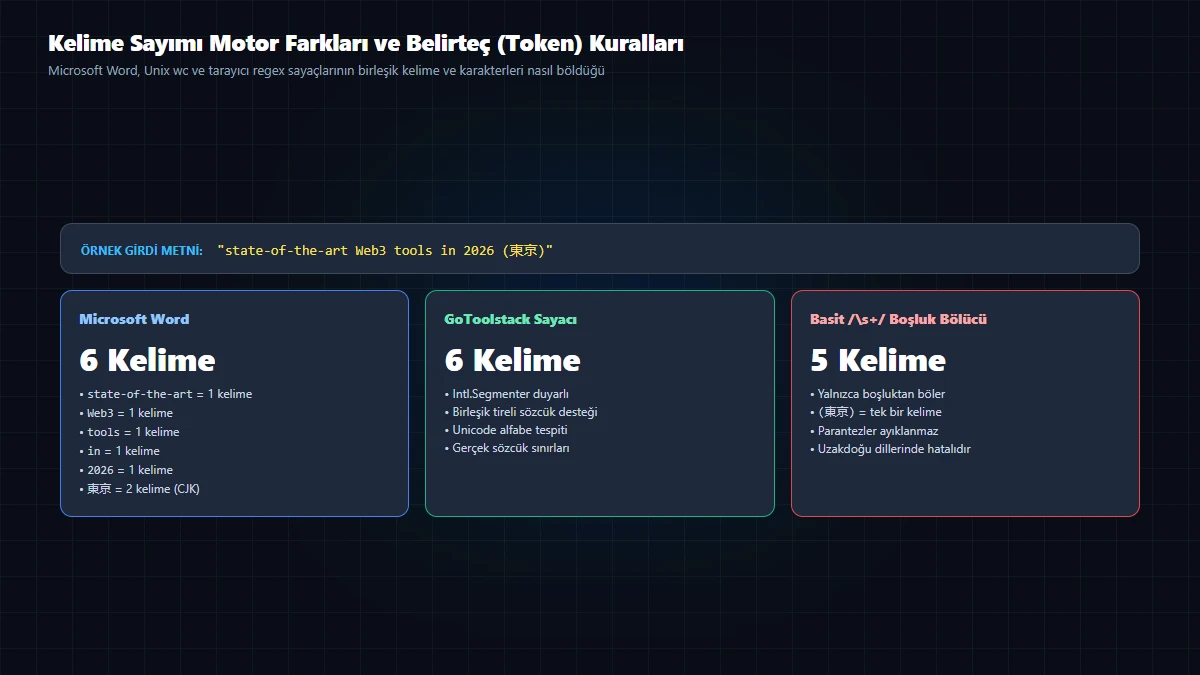
- Word, tire ile ayrılan kelimeleri (örneğin
bire-bir) varsayılan olarak tek kelime sayar. - Microsoft Word'de Sözcük Sayımı iletişim kutusunda "Metin kutularını, dipnotları ve sonnotları ekle" seçeneği bulunur; ancak Word üst bilgi ve alt bilgileri belge toplam sözcük sayımına varsayılan olarak kesinlikle DAHİL ETMEZ Sözcük Sayımı iletişim kutusundaki (Gözden Geçir > Sözcük Sayımı) Metin kutularını, dipnotları ve sonnotları ekle onay kutusuna bağlıdır. Bu kutu işaretliyse Word, web sayacına yapıştırdığınız gövde metninden daha yüksek bir sayı verir.
- Eğik çizgi ile birleştirilen ifadeler (
evet/hayır) Word'ün dil denetimi sözlüğüne göre tek veya iki kelime olarak yorumlanabilir.
5. Okuma ve Konuşma Süresi: Hız Varsayımları ve Tahminler
Bir sayacın gösterdiği okuma veya konuşma süresi evrensel bir biyolojik saat değil, istatistiksel bir hız varsayımıdır:
- Sessiz Okuma Süresi: GoToolstack, ortalama yetişkin okuma hızı için dakikada 200 kelime (WPM) kabul eder (
Math.round(words / 200)). Akademik meta-analizler (Brysbaert, 2019), kurgusal olmayan metinlerde ortalama yetişkin okuma hızını 238 kelime/dakika olarak belirlemiştir. Teknik ve akademik metinlerde bu hız 150-180 kelimeye düşer. - Sesli Konuşma Süresi: GoToolstack, konuşma hızı için dakikada 130 kelime kabul eder (
Math.round(words / 130)). Profesyonel sunum ve hitabet standartları (Toastmasters kılavuzları) 120-150 kelime/dakika aralığını önerir.
6. Boşluksuz Diller: Çince ve Japonca (CJK) Sınırları
Çince ve Japoncada kelimeler arasına boşluk konulmaz (örneğin 我喜欢编写软件 veya 日本語の文字数).
GoToolstack'in kelime motoru bitişik Unicode harflerini tek blok olarak grupladığından ([\p{L}\p{N}]+), boşluksuz bir Çince cümlenin tamamı tek bir kelime olarak sayılır! 500 karakterlik boşluksuz bir Çince metin yapıştırdığınızda kelime sayısı 1 çıkabilir. Bu nedenle Çince ve Japonca metinlerde esas alınması gereken metrik kelime sayısı değil, Boşluksuz Karakter Sayısı (charsns) metriğidir.
7. GoToolstack Metin Araçları
Metinlerinizi sunucuya göndermeden, tarayıcınızda güvenle analiz edin ve dönüştürün:
Teknik Referanslar ve Resmi Standartlar
- Microsoft Support: Microsoft Word'de sözcük sayısını görüntüleme (Masaüstü, Web, Mac ve dipnot dahil etme kuralları).
- Brysbaert, M. (2019): Dakikada kaç kelime okuyoruz? Okuma hızının meta-analizi ve sistematik incelemesi (Journal of Memory and Language, 109, 104047).
- Unicode Standard Annex #29: Unicode Metin Segmentasyonu (Sözcük Sınırları, Grafem Kümeleri ve Cümle Ayrıştırma).