Почему количество слов в Microsoft Word и онлайн-счетчиках различается
Содержание
- Прямой диагноз: почему счетчики слов показывают разный результат
- Четыре ключевые метрики: Слова, Символы с/без пробелов, Абзацы
- Движок счетчика GoToolstack: Логика исходного кода
- Microsoft Word против онлайн-счетчиков: Правила Word
- Время чтения и речи: Формулы и скорости
- Языки без пробелов: Особенности китайского и японского (CJK)
- Текстовые инструменты GoToolstack
- Технические стандарты и официальные спецификации
1. Прямой диагноз: почему счетчики слов показывают разный результат
Вставив один и тот же текст в Microsoft Word, Google Документы и онлайн-счетчик, вы часто получите три разных значения. Это не системная ошибка, а прямое следствие различий в алгоритмах токенизации и правилах определения границ слов.
Расхождения связаны с пятью ключевыми техническими моментами:
- Слова через дефис: Считается ли
бизнес-процессилиstate-of-the-artза одно слово или за несколько? - Апострофы: Как обрабатываются сокращения вроде
don'tили именаД'Артаньян? - Дефис и тире: Разница между коротким дефисом (
-) и длинным тире (—/–). - Эмодзи и длина UTF-16: Считается ли эмодзи за 1 символ или занимает 2 кодовые единицы UTF-16?
- Языки без пробелов (CJK): Как определяются слова в китайском и японском языках при отсутствии пробелов.
2. Четыре ключевые метрики: Слова, Символы с/без пробелов, Абзацы
Перед сравнением инструментов необходимо четко разграничивать эти показатели:
| Метрика | Что измеряет | Техническое определение |
|---|---|---|
| Слова | Лексические единицы | Последовательности букв и цифр Unicode, ограниченные пробелами или знаками. |
| Символы (с пробелами) | Общий размер текста | Все кодовые единицы, включая пробелы, табуляцию и переводы строк. |
| Символы (без пробелов) | Плотность видимого текста | Длина строки после удаления всех пробельных символов ASCII и Unicode. |
| Абзацы | Структурные блоки | Непустые текстовые блоки, разделенные переводами строк (\n+). |
3. Движок счетчика GoToolstack: Логика исходного кода
В клиентском счетчике GoToolstack подсчет выполняется регулярным выражением JavaScript:
const rawWords = v.match(/[\p{L}\p{N}]+(?:['’\-][\p{L}\p{N}]+)*/gu) || [];
const words = rawWords.length;
const chars = v.length;
const charsns = v.replace(/\s/g, '').length;
const sentences = (v.match(/[.!?]+(\s|$)/g) || []).length;
const paras = v.trim() === '' ? 0 : v.split(/\n+/).filter(p => p.trim().length > 0).length;
Практические особенности этого движка:
- Слова через дефис: Благодаря выражению
(?:['’\-][\p{L}\p{N}]+)*конструкцииинтернет-магазиниstate-of-the-artсчитаются за 1 слово. - Апострофы: Прямой (
') и типографский (’) апострофы внутри слова сохраняют его целостность (например,don't= 1 слово). - Тире (Em-dash): Длинное тире (
—) не входит в группу, поэтомупроект—результатразделяется на 2 слова. - Эмодзи и UTF-16:
v.lengthсчитает суррогатные пары. Одиночный эмодзи 🚀 занимает 2 единицы, а семейный составной эмодзи — 11 единиц.
4. Microsoft Word против онлайн-счетчиков: Правила Word
В Microsoft Word (согласно официальной документации Microsoft Word):
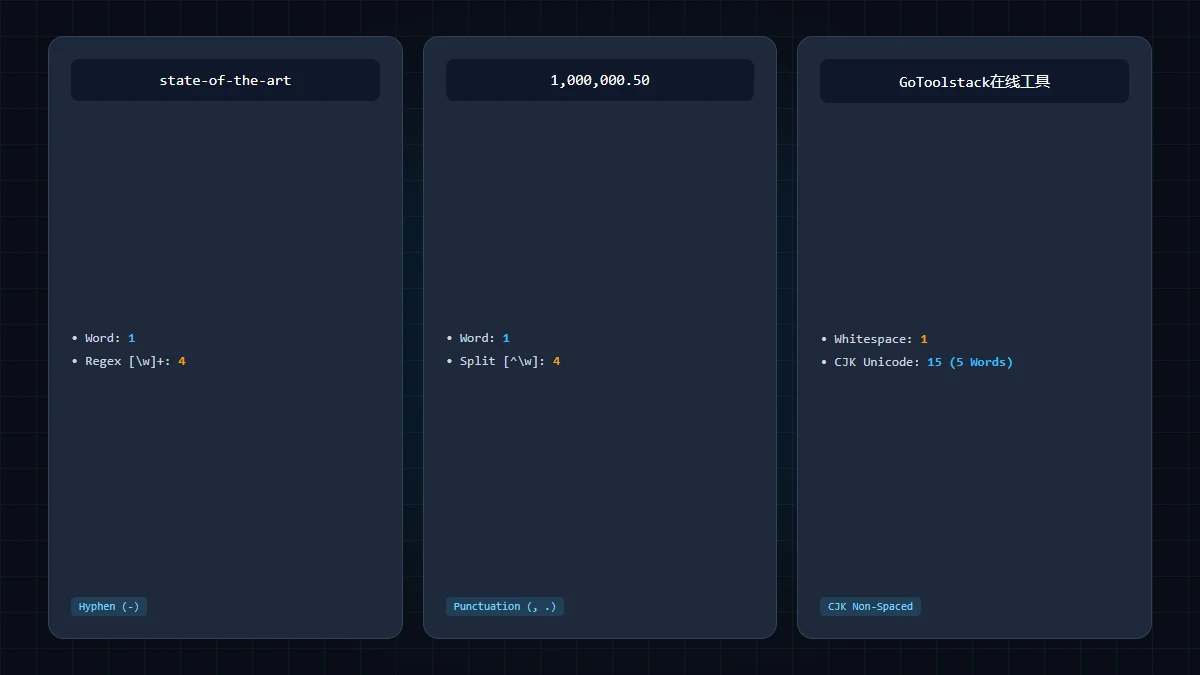
- Word по умолчанию считает слова, соединенные дефисом, за 1 слово.
- Учет сносок и надписей зависит от флага Учитывать надписи, сноски и концевые сноски в окне Статистика.
- Слова со слэшем (
да/нет) могут считаться как одно или два слова в зависимости от языковых словарей проверки.
5. Время чтения и речи: Формулы и скорости
Расчетное время представляет собой среднюю статистическую оценку:
- Скорость чтения про себя: GoToolstack принимает 200 слов в минуту (WPM) (
Math.round(words / 200)). Исследования (Brysbaert, 2019) показывают в среднем 238 WPM для научно-популярных текстов и 150–180 WPM для технической литературы. - Скорость устной речи: Принята норма 130 слов в минуту (
Math.round(words / 130)), оптимальная для докладов и презентаций.
6. Языки без пробелов: Особенности китайского и японского (CJK)
В китайском и японском языках предложения пишутся слитно без пробелов между словами (например, 我喜欢编写软件 или 日本語の文字数を数える).
Поскольку регулярное выражение группирует непрерывные символы Unicode ([\p{L}\p{N}]+), предложение без пробелов распознается как 1 слово. Для текстов CJK необходимо ориентироваться на показатель Символы (без пробелов) (charsns).
7. Текстовые инструменты GoToolstack
Анализируйте и форматируйте тексты локально в браузере без отправки на сервер:
Технические стандарты и официальные спецификации
- Microsoft Support: Отображение статистики количества слов в Microsoft Word (Настольная версия, веб, Mac и сноски).
- Brysbaert, M. (2019): Сколько слов в минуту мы читаем? Обзор и мета-анализ скорости чтения (Journal of Memory and Language).
- Unicode Standard Annex #29: Стандарт сегментации текста Unicode (Границы слов, кластеры графем и предложений).