Por que você não consegue selecionar ou copiar texto em um PDF: Causas e soluções
Índice de conteúdo
1. Diagnóstico direto: Por que o texto de um PDF não pode ser copiado
Quando o mouse não seleciona texto em um PDF ou quando o conteúdo colado resulta em símbolos ilegíveis ( ou blocos pretos), o documento não está corrompido aleatoriamente. Há quatro explicações técnicas distintas, e assumir sempre que 'falta OCR' causa perda de tempo e retrabalho.
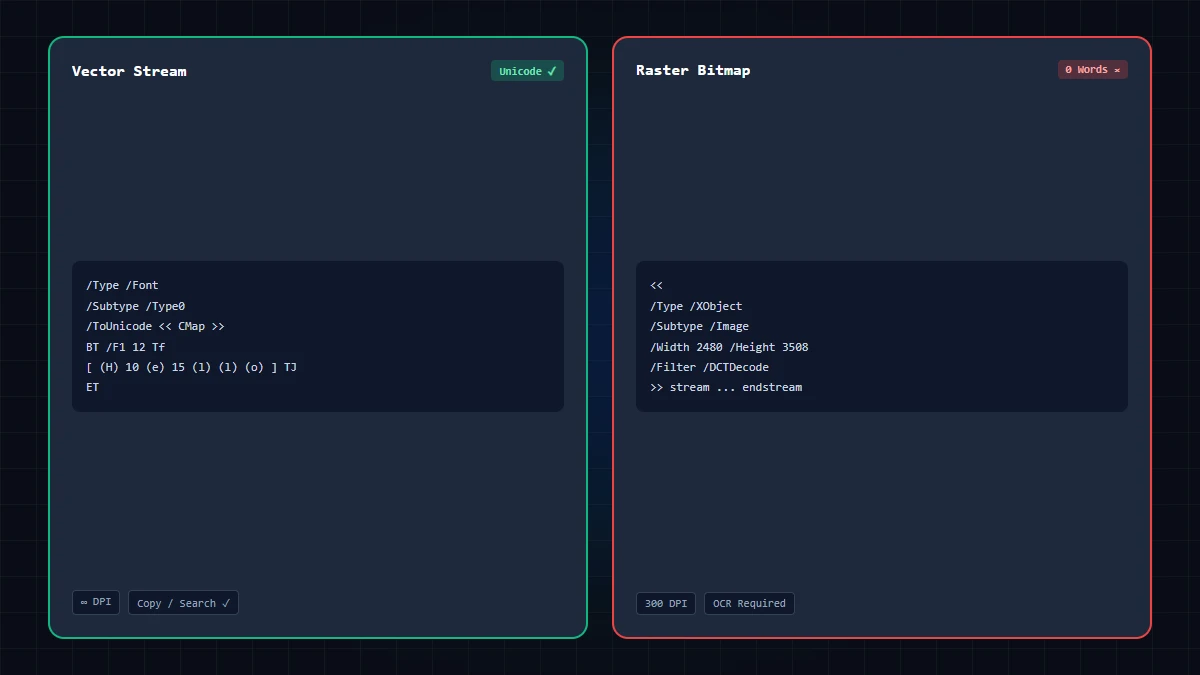
Quatro categorias técnicas de falha:
- PDF escaneado composto de imagens: A página contém apenas gráficos bitmap (XObject). Não há nenhum operador de texto (
BT ... ET,Tj) na sintaxe do arquivo. - Compressão por rasterização: O PDF com texto foi comprimido por ferramenta baseada em imagem (como o compressor Canvas do GoToolstack), convertendo fontes vetoriais em pixels JPEG.
- Permissões de segurança (DRM): A camada de texto existe, mas o dicionário de proteção desativou o recurso 'Copiar conteúdo' (bit 5).
- Falha na tabela ToUnicode CMap: O texto é selecionável, mas a fonte incorporada não tem tabela de conversão para Unicode. Ao colar, surgem caracteres embaralhados (mojibake). Isso é erro de fonte, NÃO de OCR!
2. Diagnóstico rápido em 4 etapas
Identifique a falha em menos de 30 segundos:
Passo 1: Teste visual do cursor
Passe o mouse sobre o texto. O ponteiro vira um cursor em I (I) ou permanece como mão/seta? Se não mudar, não há texto vetorial ativo.
Passo 2: Busca na página (Ctrl+F / Cmd+F)
Pressione Ctrl+F e pesquise uma palavra visível. Se o leitor apontar zero ocorrências apesar da palavra legível, a página é puramente gráfica.
Passo 3: Teste de colagem no Bloco de Notas (ToUnicode CMap)
Se o texto puder ser selecionado, cole no Bloco de Notas. Se surgirem símbolos truncados (#@&^!), há falha de ToUnicode CMap.
Passo 4: Propriedades do documento (Ctrl+D)
Pressione Ctrl+D no visualizador PDF. Na aba Segurança, verifique Cópia de conteúdo: Permitida ou Não permitida.
3. Compressor PDF do GoToolstack: Mecânica real em Canvas
O código-fonte do GoToolstack confirma que nosso compressor opera por rasterização em HTML5 Canvas:
Cada página é desenhada em um <canvas> e reconstruída como JPEG com jsPDF. Por isso, comprimir PDFs no GoToolstack converte permanentemente texto em imagem, descartando formulários e assinaturas digitais.
Diferença crucial: Softwares avançados de desktop (Ghostscript, Adobe Acrobat Pro) recompactam fluxos de imagem mantendo o texto vetorial ileso. Mantenha sempre um arquivo de backup antes de comprimir.
4. Papel e limites reais do OCR
O OCR analisa padrões visuais e adiciona uma camada invisível de texto selecionável sobreposta à imagem escaneada.
A documentação técnica da Adobe adverte sobre as limitações do OCR:
- Resolução: Imagens abaixo de 300 DPI confundem caracteres frequentemente (
1comlouI;rncomm). - Alinhamento: Inclinações a partir de 2 a 3 graus reduzem fortemente a taxa de reconhecimento.
- Tabelas complexas: Colunas múltiplas e notas de rodapé podem desorganizar a ordem natural de leitura da camada de texto.
O GoToolstack não utiliza servidores OCR em nuvem. Nossa ferramenta offline processa Tesseract.js no navegador conforme a memória disponível no cliente.
5. Resumo e lista de verificação
- Cursor de mão + busca sem resultado = PDF de imagem (necessita OCR).
- Texto selecionável + copiar bloqueado = Restrição DRM (revisar permissões de segurança).
- Texto selecionável + colagem ilegível = Falha ToUnicode CMap (erro de codificação de fonte, não OCR).
- Guarde sempre a versão original com texto antes de aplicar compressão por imagem.
6. Ferramentas PDF GoToolstack
Manipule documentos localmente sem envio a servidores externos:
Referências técnicas e normas oficiais
- Adobe Acrobat User Guide: Editar PDFs digitalizados – Geração de camada de texto com OCR versus rasterização.
- Adobe Acrobat Learn & Support: Proteger PDFs com senhas e permissões (Dicionário /Encrypt e restrições de cópia de conteúdo).
- ISO 32000-1:2008 / ISO 32000-2:2020: Gerenciamento de documentos – Formato de Documento Portátil (Catálogo PDF, formulários AcroForm e assinaturas).