माइक्रोसॉफ्ट वर्ड और ऑनलाइन काउंटर्स में शब्द संख्या अलग क्यों आती है?
विषय सूची
- प्रत्यक्ष विश्लेषण: वर्ड काउंटर्स में परिणाम अलग क्यों आते हैं?
- चार महत्वपूर्ण मेट्रिक्स: शब्द, वर्ण (स्पेस सहित/रहित), और पैराग्राफ
- GoToolstack वर्ड काउंटर इंजन: वास्तविक कोड कार्यप्रणाली
- Microsoft Word बनाम ऑनलाइन काउंटर्स: आधिकारिक वर्ड नियम
- पढ़ने और बोलने का अनुमानित समय: गति मॉडल
- बिना स्पेस वाली भाषाएं: चीनी और जापानी (CJK) सीमाएं
- GoToolstack टेक्स्ट टूल्स
- तकनीकी संदर्भ और आधिकारिक मानक
1. प्रत्यक्ष विश्लेषण: वर्ड काउंटर्स में परिणाम अलग क्यों आते हैं?
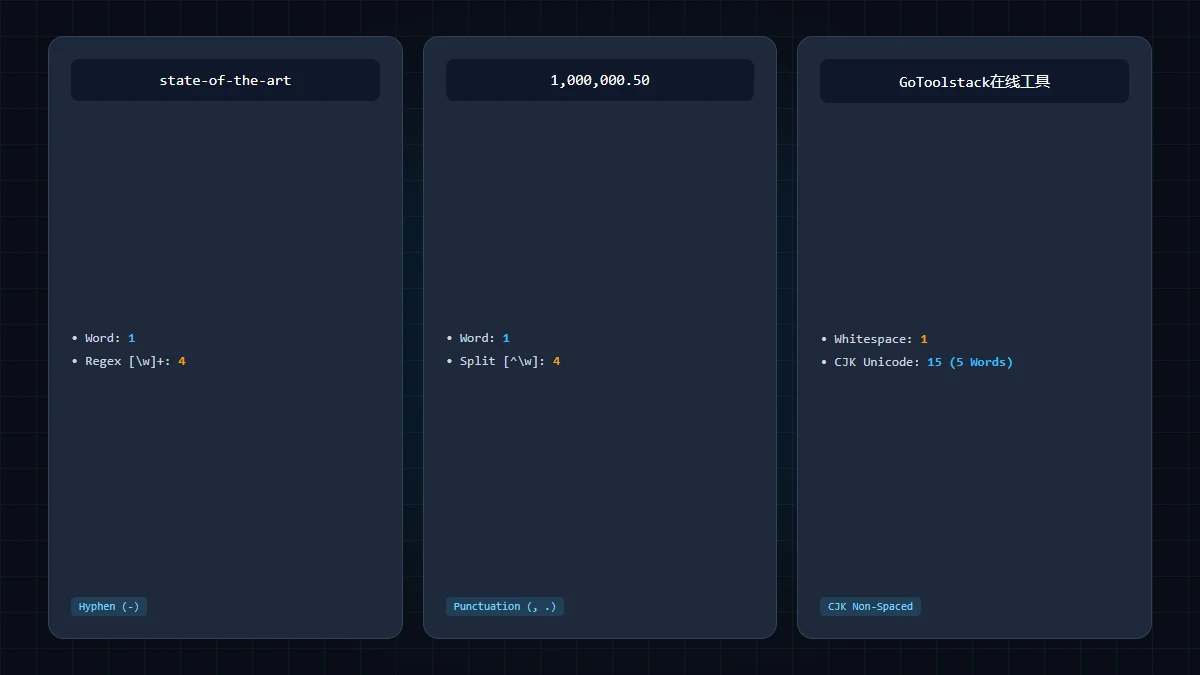
जब आप एक ही टेक्स्ट को Microsoft Word, Google Docs और किसी ऑनलाइन वर्ड काउंटर में पेस्ट करते हैं, तो अक्सर अलग-अलग संख्याएं मिलती हैं। यह किसी बग के कारण नहीं, बल्कि प्रत्येक सॉफ्टवेयर के टेक्स्ट विभाजन (Tokenization) एल्गोरिदम और नियमों के अंतर का स्वाभाविक परिणाम है।
लगभग 95% अंतर इन पांच प्रमुख तकनीकी कारणों से होते हैं:
- हाइफ़न वाले शब्द:
state-of-the-artको 1 शब्द माना जाए या 4 शब्द? - एपोस्ट्रॉफी वाले शब्द:
don'tयाuser'sको एक शब्द गिना जाए या दो? - डैश और हाइफ़न का अंतर: सामान्य हाइफ़न (
-) और लंबे डैश (—/–) का प्रभाव। - इमोजी और UTF-16 कोड इकाइयां: क्या इमोजी को 1 वर्ण माना जाए या 2 कोड इकाइयां?
- बिना स्पेस वाली भाषाएं (CJK): चीनी और जापानी में बिना स्पेस के शब्दों की पहचान कैसे होती है।
2. चार महत्वपूर्ण मेट्रिक्स: शब्द, वर्ण (स्पेस सहित/रहित), और पैराग्राफ
तुलना करने से पहले इन चार अलग-अलग गणनाओं को समझना आवश्यक है:
| मीट्रिक | क्या मापता है | तकनीकी परिभाषा |
|---|---|---|
| शब्द (Words) | शाब्दिक इकाइयां | स्पेस या विराम चिह्नों द्वारा अलग किए गए अक्षरों/संख्याओं का समूह। |
| वर्ण (स्पेस सहित) | कुल टेक्स्ट बफर | स्पेस, टैब और न्यूलाइन सहित कुल कैरेक्टर संख्या। |
| वर्ण (स्पेस रहित) | वास्तविक पाठ घनत्व | सभी रिक्त स्थानों को हटाने के बाद शुद्ध अक्षरों की संख्या। |
| पैराग्राफ | संरचनात्मक ब्लॉक | न्यूलाइन (\n+) द्वारा अलग किए गए गैर-रिक्त टेक्स्ट ब्लॉक। |
3. GoToolstack वर्ड काउंटर इंजन: वास्तविक कोड कार्यप्रणाली
GoToolstack का ब्राउज़र-आधारित टूल निम्नलिखित जावास्क्रिप्ट रेगुलर एक्सप्रेशन का उपयोग करता है:
const rawWords = v.match(/[\p{L}\p{N}]+(?:['’\-][\p{L}\p{N}]+)*/gu) || [];
const words = rawWords.length;
const chars = v.length;
const charsns = v.replace(/\s/g, '').length;
const sentences = (v.match(/[.!?]+(\s|$)/g) || []).length;
const paras = v.trim() === '' ? 0 : v.split(/\n+/).filter(p => p.trim().length > 0).length;
इस इंजन के वास्तविक परिणाम:
- हाइफ़न वाले शब्द: नियम
(?:['’\-][\p{L}\p{N}]+)*के कारणstate-of-the-artको 1 शब्द गिना जाता है। - एपोस्ट्रॉफी: सीधे (
') और घुमावदार (’) एपोस्ट्रॉफी वाले शब्द 1 शब्द के रूप में सुरक्षित रहते हैं। - लंबा डैश (Em-dash): लंबा डैश (
—) समूह में न होने के कारणशब्द1—शब्द2को 2 अलग शब्दों में बांटता है। - इमोजी:
v.lengthUTF-16 इकाइयों को मापता है। इमोजी 🚀 2 वर्ण और संयुक्त पारिवारिक इमोजी 11 इकाइयां देता है।
4. Microsoft Word बनाम ऑनलाइन काउंटर्स: आधिकारिक वर्ड नियम
Microsoft Word में (Microsoft Word आधिकारिक दस्तावेज़ के अनुसार):
- Word डिफ़ॉल्ट रूप से हाइफ़न से जुड़े शब्दों को 1 शब्द मानता है।
- फ़ुटनोट और टेक्स्ट बॉक्स की गणना वर्ड काउंट विंडो में टेक्स्ट बॉक्स, फ़ुटनोट और एंडनोट शामिल करें विकल्प पर निर्भर करती है।
- स्लैश वाले शब्द (
हाँ/ना) व्याकरण शब्दकोश के आधार पर एक या दो शब्दों के रूप में गिने जा सकते हैं।
5. पढ़ने और बोलने का अनुमानित समय: गति मॉडल
प्रदर्शित समय कोई निश्चित नियम नहीं बल्कि सांख्यिकीय अनुमान है:
- मौन वाचन गति: GoToolstack 200 शब्द प्रति मिनट (WPM) मानता है (
Math.round(words / 200))। शोध (Brysbaert, 2019) के अनुसार सामान्य वयस्क पढ़ने की गति 238 WPM और तकनीकी ग्रंथों में 150-180 WPM होती है। - बोलने की गति: प्रस्तुति मानकों के अनुसार 130 शब्द प्रति मिनट (
Math.round(words / 130)) की दर लागू की जाती है।
6. बिना स्पेस वाली भाषाएं: चीनी और जापानी (CJK) सीमाएं
चीनी और जापानी में शब्दों के बीच स्पेस नहीं दिया जाता (जैसे: 我喜欢编写软件 या 日本語の文字数を数える)।
चूंकि इंजन सन्निहित यूनिकोड अक्षरों को एक साथ जोड़ता है ([\p{L}\p{N}]+), इसलिए बिना स्पेस वाला चीनी वाक्य 1 शब्द गिना जाएगा। अतः CJK भाषाओं के लिए केवल वर्ण (स्पेस रहित) (charsns) को ही सही पैमाना मानें।
7. GoToolstack टेक्स्ट टूल्स
बिना सर्वर अपलोड के अपने ब्राउज़र में टेक्स्ट का सुरक्षित विश्लेषण और रूपांतरण करें:
तकनीकी संदर्भ और आधिकारिक मानक
- Microsoft Support: Microsoft Word में शब्द गणना दिखाएं (डेस्कटॉप, वेब, मैक और फ़ुटनोट विकल्प).
- Brysbaert, M. (2019): हम प्रति मिनट कितने शब्द पढ़ते हैं? पढ़ने की दर का मेटा-विश्लेषण (Journal of Memory and Language).
- Unicode Standard Annex #29: यूनिकोड टेक्स्ट सेगमेंटेशन (शब्द सीमाएं, ग्रैफीम क्लस्टर और वाक्य विभाजन).