एक्सेल में CSV फाइलें क्यों बिगड़ती हैं: UTF-8 एन्कोडिंग, विभाजक और शून्य की समस्या
विषय सूची
- प्रत्यक्ष निदान: फ़ाइल प्रारूप बनाम एक्सेल का स्वचालित अनुमान
- अक्षरों के बिगड़ने (Mojibake) का जाल: UTF-8 बनाम UTF-8 BOM
- कॉमा बनाम सेमीकोलन का क्षेत्रीय टकराव (कॉलम A में डेटा का जमाव)
- फ़ील्ड के भीतर उद्धरण चिह्न और लाइन ब्रेक (RFC 4180 मानक)
- शुरुआती शून्य का गायब होना और 15-अंकीय सटीकता सीमा
- माइक्रोसॉफ्ट एक्सेल में आधिकारिक सुरक्षित आयात प्रक्रिया
- CSV के लिए GoToolstack के सुरक्षित ब्राउज़र टूल्स
- तकनीकी संदर्भ और आधिकारिक मानक
1. प्रत्यक्ष निदान: फ़ाइल प्रारूप बनाम एक्सेल का स्वचालित अनुमान
CSV (कॉमा-सेपरेटेड वैल्यूज़) फ़ाइल केवल एक सादा टेक्स्ट डेटा स्ट्रीम है। इसमें केवल वर्ण, फ़ील्ड विभाजक और लाइन ब्रेक होते हैं। जब एक्सेल में CSV फ़ाइल खोली जाती है और वर्ण बिगड़ जाते हैं, सारा डेटा कॉलम A में सिमट जाता है, या क्रेडिट कार्ड नंबरों के अंतिम अंक शून्य हो जाते हैं, तो मूल फ़ाइल आमतौर पर खराब नहीं होती। समस्या एक्सेल द्वारा डबल-क्लिक पर लागू किए जाने वाले डिफ़ॉल्ट अनुमानों में होती है।
डबल-क्लिक करने पर एक्सेल फ़ाइल के वास्तविक एन्कोडिंग या विभाजक की पुष्टि किए बिना विंडोज की स्थानीय सेटिंग्स के आधार पर अनुमान लगाता है। इस समस्या से बचने के लिए चार तकनीकी नियमों को समझना आवश्यक है:
2. अक्षरों के बिगड़ने (Mojibake) का जाल: UTF-8 बनाम UTF-8 BOM
आधुनिक वेब एप्लिकेशन और डेटाबेस मानक UTF-8 में बिना BOM के टेक्स्ट उत्पन्न करते हैं। लेकिन विंडोज पर डेस्कटॉप एक्सेल डबल-क्लिक करने पर स्थानीय ANSI कोड पेज का उपयोग करता है।
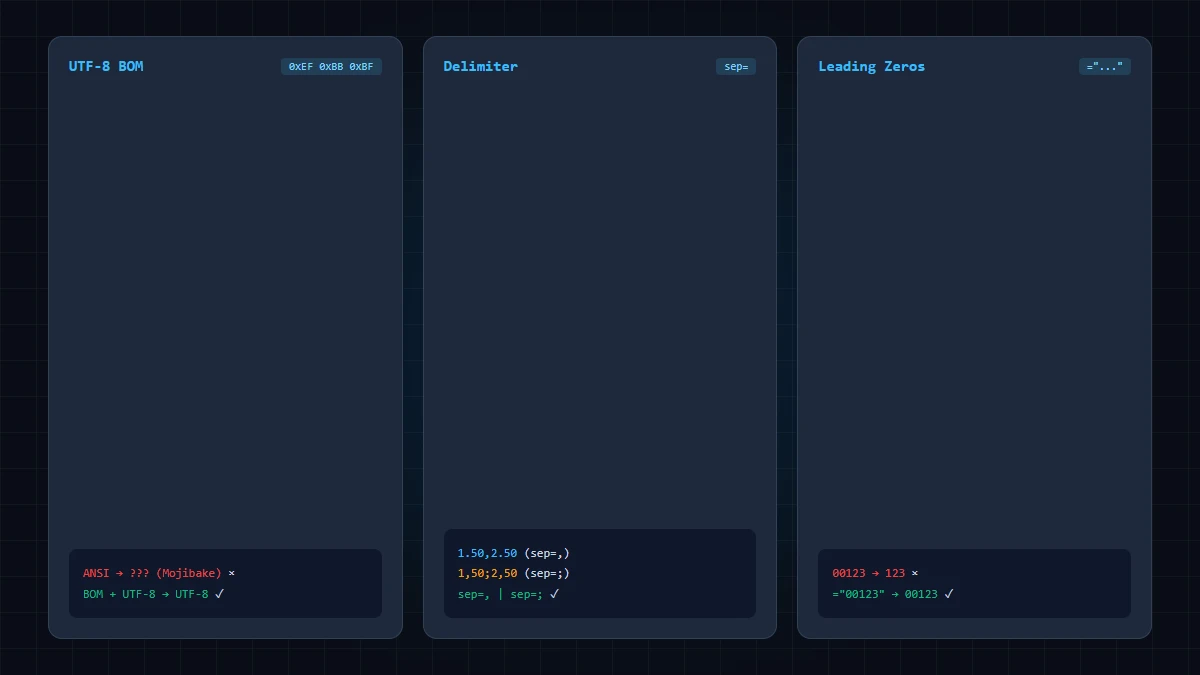
फ़ाइल की शुरुआत में 3-बाइट पहचानकर्ता (BOM: 0xEF, 0xBB, 0xBF) न होने पर एक्सेल मल्टी-बाइट UTF-8 वर्णों को अलग-अलग अक्षरों के रूप में पढ़ता है, जिससे टेक्स्ट विकृत हो जाता है:
| मूल इच्छित टेक्स्ट | एक्सेल में बिगड़ा हुआ टेक्स्ट (बिना BOM) | त्रुटि का कारण |
|---|---|---|
München / İstanbul |
München / İstanbul |
UTF-8 2-byte → ANSI Mojibake |
Français / Español |
Français / Español |
Diacritics parsed as individual code points |
€ 1,500 / ₺ 5,000 / ¥ 10,000 |
€ 1,500 / ₺ 5,000 / ¥ 10,000 |
Multi-byte currency symbols decoded into ANSI artifacts |
एक्सेल उपयोगकर्ताओं के लिए CSV बनाते समय फ़ाइल में हमेशा UTF-8 BOM शामिल करें। GoToolstack के JSON ↔ CSV कनवर्टर में बस Excel के लिए UTF-8 BOM (\uFEFF) जोड़ें को चुनें।
3. कॉमा बनाम सेमीकोलन का क्षेत्रीय टकराव (कॉलम A में डेटा का जमाव)
अमेरिका और यूके में दशमलव के लिए बिंदु (12.50) और सूची विभाजक के लिए कॉमा उपयोग होता है। लेकिन यूरोप में दशमलव के लिए कानूनी रूप से कॉमा (12,50) का उपयोग किया जाता है।
चूंकि कॉमा एक साथ दशमलव बिंदु और कॉलम विभाजक नहीं हो सकता, इसलिए उन क्षेत्रों में विंडोज सेटिंग्स में सेमीकोलन (;) को डिफ़ॉल्ट विभाजक बनाया जाता है। कॉमा वाली CSV को डबल-क्लिक से खोलने पर एक्सेल को सेमीकोलन नहीं मिलता और वह पूरी पंक्ति को कॉलम A में डाल देता है।
डेटा को सेमीकोलन के साथ निर्यात करें या एक्सेल के डेटा > टेक्स्ट/CSV से विकल्प का उपयोग करके कॉमा का चयन करें।
4. फ़ील्ड के भीतर उद्धरण चिह्न और लाइन ब्रेक (RFC 4180 मानक)
जब किसी सेल में कॉमा, सेमीकोलन या मल्टी-लाइन पता होता है, तो RFC 4180 मानक के अनुसार फ़ील्ड को दोहरे उद्धरण चिह्नों में बंद करना आवश्यक है। आंतरिक उद्धरण चिह्नों को दोहराकर ("") एस्केप किया जाता है:
ID,Customer,Address,Notes
101,"Acme, Inc.","123 Industrial Way
Suite 400","Order confirmed with ""Express"" shipping"
5. शुरुआती शून्य का गायब होना और 15-अंकीय सटीकता सीमा
एक्सेल बिना फ़ॉर्मैट वाली CSV को पढ़ते समय डेटा प्रकार का अनुमान लगाता है। यदि किसी सेल में केवल अंक हैं, तो एक्सेल उसे स्वचालित रूप से फ्लोटिंग-पॉइंट संख्या में बदल देता है, जिससे दो अपूरणीय डेटा हानियाँ होती हैं:
शुरुआती शून्य का विलोपन: पिन कोड और फोन नंबर (जैसे "01234") पूर्णांक (1234) में बदल जाते हैं। शुरुआती शून्य मेमोरी से हमेशा के लिए हट जाते हैं।
15-अंकीय सटीकता सीमा (एक्सेल इंजन बनाम IEEE 754): माइक्रोसॉफ्ट एक्सेल का स्प्रेडशीट इंजन संख्यात्मक सटीकता को अधिकतम 15 अंकों तक सीमित करता है। यद्यपि सामान्य IEEE 754 मानक 253 (9,007,199,254,740,992, यानी 16 अंक) तक सटीक पूर्णांक रख सकता है, एक्सेल अपने आंतरिक नियम के अनुसार 15वें अंक के बाद के सभी अंकों को 0 में बदल देता है (1234567890123456 → 1234567890123450)!
गंभीर चेतावनी: फ़ाइल खोलने के बाद सेल को 'टेक्स्ट' में बदलने से कटे हुए अंक कभी वापस नहीं आते। मेमोरी में लोड होते ही मूल डेटा नष्ट हो जाता है।
6. माइक्रोसॉफ्ट एक्सेल में आधिकारिक सुरक्षित आयात प्रक्रिया
बिना किसी डेटा हानि या विकृति के किसी भी CSV को खोलने के लिए Power Query का उपयोग करें:
- एक्सेल को एक खाली वर्कबुक के साथ खोलें (CSV फ़ाइल पर डबल-क्लिक न करें)।
- शीर्ष मेनू से डेटा > डेटा प्राप्त करें > फ़ाइल से > टेक्स्ट/CSV से चुनें।
- पूर्वावलोकन विंडो में फ़ाइल मूल: को
65001: Unicode (UTF-8)पर सेट करें। - विभाजक: को कॉमा या सेमीकोलन के रूप में चुनें।
- सीधे लोड करने के बजाय डेटा रूपांतरित करें पर क्लिक करें और Power Query में आईडी और फोन नंबर कॉलम का प्रकार टेक्स्ट करें।
- बिना किसी नुकसान के डेटा आयात करने के लिए बंद करें और लोड करें पर क्लिक करें।
- मूल कच्ची CSV फ़ाइल को अधिलेखित (overwrite) करने से बचने के लिए कार्यपुستिका को Excel कार्यपुस्तिका (
.xlsx) के रूप में सहेजें, जिससे original मूल डेटा सुरक्षित रहे।
7. CSV के लिए GoToolstack के सुरक्षित ब्राउज़र टूल्स
बाहरी सर्वर पर डेटा भेजे बिना सीधे अपने ब्राउज़र में टेबल डेटा सुरक्षित रूप से संसाधित करें:
- JSON ↔ CSV कनवर्टर: UTF-8 BOM जोड़ें, विभाजक चुनें और लाइन एंडिंग्स अनुकूलित करें।
- Excel ↔ CSV/JSON कनवर्टर: SheetJS इंजन के साथ ब्राउज़र मेमोरी में तेज़ रूपांतरण।
- डेवलपर टूल्स हब: डेटा फ़ॉर्मेटिंग और सत्यापन उपकरणों का पूरा संग्रह।
तकनीकी संदर्भ और आधिकारिक मानक
- IETF RFC 4180: कॉमा-सेपरेटेड वैल्यूज़ (CSV) फाइलों के लिए सामान्य प्रारूप और MIME प्रकार विनिर्देश.
- Microsoft Learn / Support: Microsoft Excel में टेक्स्ट (.txt या .csv) फ़ाइलों को आयात या निर्यात करना (Power Query डेटा प्रकार संरक्षण).
- Unicode Consortium: अक्सर पूछे जाने वाले प्रश्न – UTF-8, UTF-16 और बाइट ऑर्डर मार्क (BOM) दिशानिर्देश.