Pourquoi le texte d'un PDF ne peut pas être sélectionné ou copié : Diagnostic et solutions
Sommaire
1. Diagnostic direct : Pourquoi le texte d'un PDF ne peut pas être copié
Si votre curseur ne sélectionne aucun mot sur un PDF ou si le texte collé se transforme en symboles illisibles ( ou carrés noirs), le fichier n'est pas endommagé au hasard. Il existe quatre explications techniques distinctes et invoquer systématiquement le manque d'OCR mène à des erreurs d'analyse.
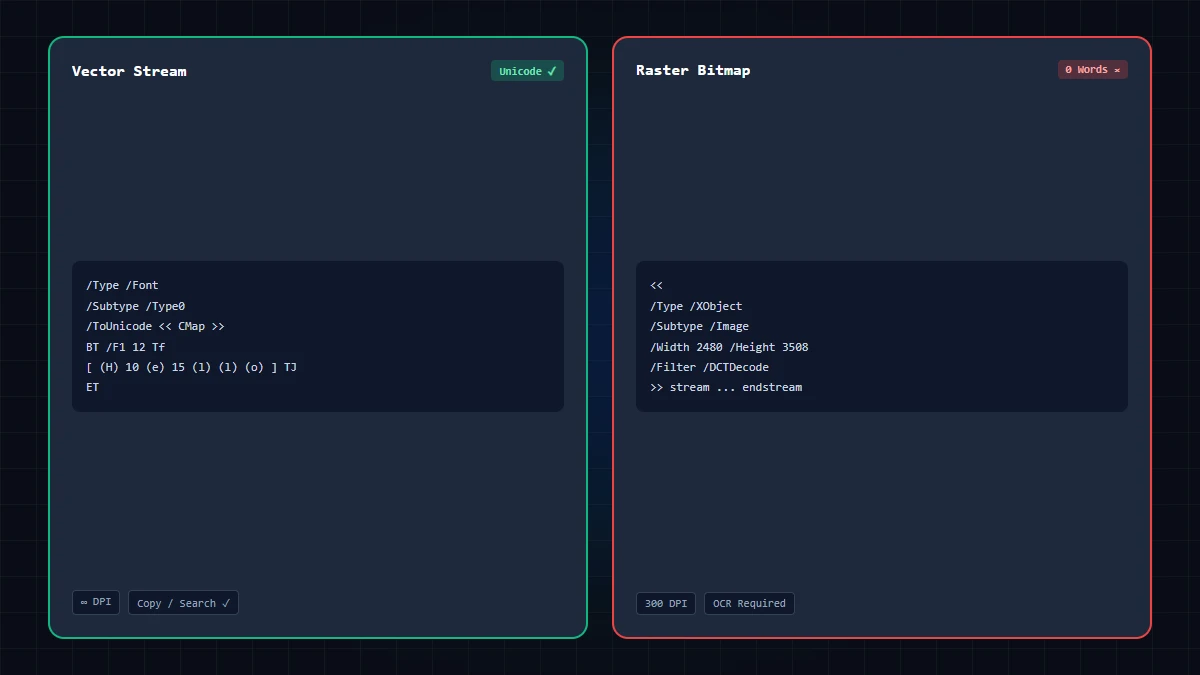
Quatre causes fondamentales :
- PDF scanné en mode image : Le document n'est qu'une succession d'images bitmap (XObject). Aucun opérateur textuel (
BT ... ET,Tj) n'est présent dans le code source du PDF. - Compression matricielle (Raster) : Le document a été compressé par un outil orienté image (comme le compresseur Canvas de GoToolstack), convertissant le texte vectoriel en pixels JPEG plats.
- Verrouillage DRM et autorisations : La couche texte existe, mais le dictionnaire de sécurité a désactivé l'autorisation de copie (bit 5).
- Défaillance de table ToUnicode CMap : Le texte est sélectionnable mais la police incorporée ne possède pas de table de mappage Unicode. Le texte collé est corrompu (mojibake). C'est un problème de police, PAS d'OCR !
2. Méthode de diagnostic en 4 étapes
Identifiez la cause exacte en moins de 30 secondes :
Étape 1 : Le test du pointeur de souris
Survolez le texte. Le pointeur devient-il un curseur de sélection en I (I) ou reste-t-il une main ou une flèche ? S'il ne change pas, aucune couche vectorielle n'est présente.
Étape 2 : La recherche dans la page (Ctrl+F / Cmd+F)
Appuyez sur Ctrl+F et cherchez un mot clairement visible. Si la recherche indique 0 résultat, la page est une simple image.
Étape 3 : Le test de collage dans le Bloc-notes (ToUnicode CMap)
Si le texte se sélectionne, collez-le dans le Bloc-notes. Si des caractères incohérents apparaissent (#@&^!), le document souffre d'une table ToUnicode CMap défectueuse.
Étape 4 : Propriétés de sécurité (Ctrl+D)
Affichez les propriétés avec Ctrl+D. Dans l'onglet Sécurité, vérifiez la ligne Copie de contenu : Autorisée ou Non autorisée.
3. Compresseur PDF GoToolstack : Fonctionnement réel sur Canvas
Le code source de GoToolstack confirme que notre compresseur opère par tramage HTML5 Canvas :
Chaque page est tracée dans un <canvas> puis réexportée en JPEG avec jsPDF. Ce traitement aplatit définitivement le texte en pixels : la sélection, les formulaires et les signatures sont effacés.
Distinction capitale : Les logiciels experts de bureau (Adobe Acrobat Pro, Ghostscript) rééchantillonnent les images sans détruire le texte vectoriel. Gardez toujours une copie de sauvegarde avant compression matricielle.
4. Rôle et limites réelles de l'OCR
L'OCR analyse les formes visuelles et superpose une couche de texte invisible et sélectionnable sur l'image scannée.
La documentation officielle d'Adobe Acrobat rappelle que l'OCR reste probabiliste :
- Résolution insuffisante : Les scans sous 300 DPI provoquent de fréquentes confusions (
1aveclouI;rnavecm). - Inclinaison : Une rotation de 2 à 3 degrés fait chuter la précision de reconnaissance.
- Tableaux élaborés : Les colonnes complexes et notes de bas de page perturbent l'ordre de lecture de la couche générée.
GoToolstack n'utilise aucun serveur cloud d'OCR. Notre outil hors ligne exécute Tesseract.js dans le navigateur selon les capacités mémoire du client.
5. Récapitulatif et grille d'action
- Curseur main + aucun résultat Ctrl+F = PDF image (nécessite un OCR).
- Texte sélectionnable + clic droit Copier grisé = Protection DRM (vérifier les permissions).
- Texte sélectionnable + collage incompréhensible = Problème ToUnicode CMap (erreur de police, pas d'OCR).
- Ne compressez jamais un document original sans en conserver une version vectorielle non modifiée.
6. Outils PDF GoToolstack
Manipulez vos documents localement sans aucun transfert externe :
Références techniques et normes officielles
- Adobe Acrobat User Guide: Modifier des PDF numérisés – Reconnaissance optique de caractères (OCR) et couche de texte.
- Adobe Acrobat Learn & Support: Sécuriser les PDF avec mots de passe et autorisations (Dictionnaire /Encrypt et restrictions de copie).
- ISO 32000-1:2008 / ISO 32000-2:2020: Gestion des documents – Format de document portable (Catalogue PDF, dictionnaires AcroForm et signatures numériques).